Ettin再ランキングは、検索候補を質問との関連性が高い順に並べ替えるCrossEncoder型モデルです。17Mから1Bまで6サイズが用意されており、応答速度、計算資源、検索精度のバランスを環境に合わせて選べます。RAGやFAQ検索で回答品質を改善したい場合は、生成AIだけでなく、検索結果の順番にも注目することが重要です。
Ettin再ランキングとは何か
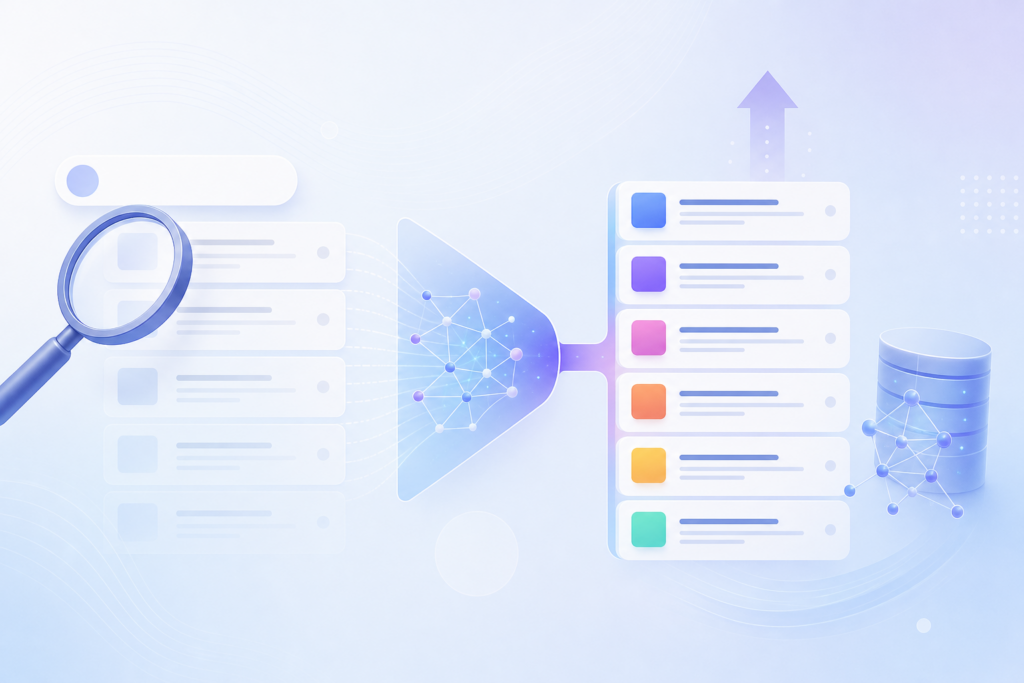
Ettin再ランキングは、検索で集めた候補文書を、ユーザーの質問にどれだけ合っているかという観点で再評価するモデルです。大量のデータを最初から詳しく読むのではなく、まず候補を絞り、その後に重要な候補を丁寧に比較します。
この仕組みは、オンラインショップの検索にたとえると理解しやすいでしょう。「軽くて雨に強い通勤用バッグ」と入力した場合、最初の検索では意味が近そうな商品を広く探します。その後、rerankerが質問文と各商品の説明を組み合わせ、「軽い」「雨に強い」「通勤用」という条件に本当に合う順番へ並べ替えます。
元記事によると、Ettin Reranker FamilyはSentence Transformersから公開されたシリーズで、ModernBERT系のEttinエンコーダを土台にしています。BERT系の技術を基盤としながら、検索や文章処理に利用しやすいモデル群として設計されている点が特徴です。
埋め込み検索とrerankerはどう役割分担するのか
埋め込みモデルは候補者を探す係、rerankerは最終審査をする係です。前者は文章を数値ベクトルに変換して意味の近さを高速に調べ、後者は質問と文書をペアで読み、両者の関係性を直接スコア化します。
埋め込み検索では、質問と文書をそれぞれベクトルに変換し、近いものを検索します。そのため大規模なデータから候補を取り出す処理に向いています。一方、細かな条件の組み合わせや、質問と文書の具体的な対応関係を深く判定する処理は、CrossEncoder型のrerankerが得意です。
ただし、rerankerは候補を1件ずつ詳しく比較するため、埋め込み検索より計算量が増えます。そこで実運用では、次のようなretrieve-then-rerank(検索してから再ランキング)の構成が現実的です。
- 埋め込みモデルで関連しそうな候補を高速に取得する
- 取得した候補をEttinのrerankerで再評価する
- スコアの高い文書を検索結果や生成AIに渡す
この役割分担により、全データを毎回深く比較する負荷を抑えながら、最終的な検索結果の関連性を高めることができます。
Ettin Reranker Familyの6サイズを比較する
Ettin Reranker Familyには、17Mから1Bまで6種類のパラメータサイズがあります。小型モデルは計算資源や応答時間を重視する環境に、大型モデルはより複雑な関連性の判断を重視する環境に向いています。
元記事で紹介されているモデル名と規模は次の通りです。パラメータ数が大きいほど必ずすべての用途で優れると断定するのではなく、候補数、ハードウェア、許容できるレイテンシと合わせて選ぶことが大切です。
| モデル名 | 規模 | 選択時の考え方 |
|---|---|---|
| cross-encoder/ettin-reranker-17m-v1 | 17M | 軽量さや短い応答時間を重視する場合 |
| cross-encoder/ettin-reranker-32m-v1 | 32M | 小規模な検証や限られた環境で試す場合 |
| cross-encoder/ettin-reranker-68m-v1 | 68M | 軽さと判定能力のバランスを考える場合 |
| cross-encoder/ettin-reranker-150m-v1 | 150M | 検索品質をさらに重視したい場合 |
| cross-encoder/ettin-reranker-400m-v1 | 400M | 計算資源を確保し、複雑な文章を扱う場合 |
| cross-encoder/ettin-reranker-1b-v1 | 1B | 速度より精度を優先して比較したい場合 |
小型モデルはCPUや限られたメモリでも扱いやすく、検索システムの応答を短くしやすい点が利点です。大型モデルは計算コストが増える一方、複雑な質問と文書の関係を判断する候補として検討できます。
蒸留と公開された学習レシピが重要な理由
Ettinシリーズでは、先生モデルの判断を生徒モデルに学ばせる蒸留が使われています。元記事によると、先生役にはmxbai-rerank-large-v2が使われ、質問と文書の組み合わせに対する関連度スコアをEttinモデルが再現するように訓練されました。
蒸留は、ベテラン審査員の採点を見ながら新人審査員を育てる方法に似ています。大規模な先生モデルをそのまま毎回動かす代わりに、その判断の傾向を比較的コンパクトなモデルへ移すことで、実用上扱いやすい選択肢を目指せます。
学習データには、LightOn AIの埋め込み事前学習データの一部と、再ランキング処理を加えたファインチューニング用データの一部が使われています。さらに、データだけでなく、学習方法や設定を含むトレーニングレシピも公開される点が重要です。
どのデータを使ったのか、どの先生モデルから知識を移したのか、どの損失関数や設定で訓練したのかを確認できれば、研究者や開発者は結果を再現したり、別の条件で改良したりしやすくなります。モデルを採用する際は、性能の印象だけでなく、こうした透明性も判断材料になります。
RAGや検索システムで導入するときの考え方
RAGでは、rerankerが生成AIへ渡す情報の質を整える役割を担います。検索結果に関連性の低い文書が多いと、LLMが誤った根拠を参照し、回答の正確性や信頼性に影響する可能性があります。
元記事では、英語検索タスクのベンチマークであるMTEBのRetrievalカテゴリを使った評価や、Googleのembeddinggemma-300mとの組み合わせが紹介されています。ただし、実際の検索品質はreranker単体だけで決まるわけではありません。
特に確認したい条件は、最初の埋め込みモデル、再評価する候補数、許容できる応答時間です。候補を10件に絞れば処理を軽くしやすい一方、必要な文書が最初の検索で漏れていると、rerankerが優秀でも後から取り戻せません。
- 速度を優先する場合:小型モデルと少ない候補数から検討する
- 検索品質を優先する場合:候補数や大きめのモデルを比較する
- 社内文書を扱う場合:質問と文書の言い回し、文書分割の方法も確認する
- 導入前に迷う場合:小型版で構成を確認し、必要に応じてサイズを上げる
評価では、モデルの大きさだけを比べるのではなく、自分の検索データと利用条件に近い構成で比較することが大切です。生成AIのプロンプトを調整しても回答が改善しないときは、そもそも正しい文書が候補に入り、適切な順番で渡されているかを見直してみましょう。
検索結果の品質を高めるには、生成モデルだけでなく、候補を探す仕組みと並べ替える仕組みを一体で設計することが重要です。
Ettin Reranker Familyの意義は、巨大モデルを一つ選ぶことではなく、17Mから1Bまで複数の選択肢を使い分けられる点にあります。小規模な検証では軽量版、本番環境で精度を優先する場合は大きめのモデルというように、用途と計算資源に合わせて設計できます。
rerankerは生成AIのように目立つ部品ではありませんが、検索、推薦、質問応答、RAGの土台を支える存在です。今後は、軽量モデルを組み合わせてシステム全体の性能を引き出す考え方が、より重要になるでしょう。
出典: Ettin Reranker Familyの紹介記事
よくある質問
Ettin再ランキングはどのようなモデルですか?
Ettin再ランキングは、質問と検索候補の文書をペアで入力し、どれほど関連しているかをスコア化して並べ替えるCrossEncoder型のモデルです。埋め込みモデルで候補を絞った後に使う構成が基本です。
埋め込みモデルとrerankerは何が違いますか?
埋め込みモデルは文章を数値ベクトルに変換し、大量のデータから意味が近い候補を高速に探します。rerankerは質問と各候補を詳しく比較し、関連性の高い順に再評価する役割を担います。
Ettin Reranker Familyには何種類ありますか?
Ettin Reranker Familyには、17M、32M、68M、150M、400M、1Bの6サイズがあります。小型モデルは速度や省メモリを重視する場合、大型モデルは計算資源を使って精度を優先したい場合に検討できます。
RAGでrerankerを使うメリットは何ですか?
RAGでは、検索結果としてLLMに渡す文書の関連性を高められる点がメリットです。関係の薄い文書が多いと回答の根拠が不適切になる可能性があるため、生成前の検索結果を整えることが重要です。
rerankerの候補数は多ければ多いほどよいですか?
候補数を増やすと必要な文書を再評価できる可能性が広がりますが、rerankerの計算量と応答時間も増えます。最初の検索で必要な文書が漏れていないかを確認し、速度と検索品質のバランスで決める必要があります。