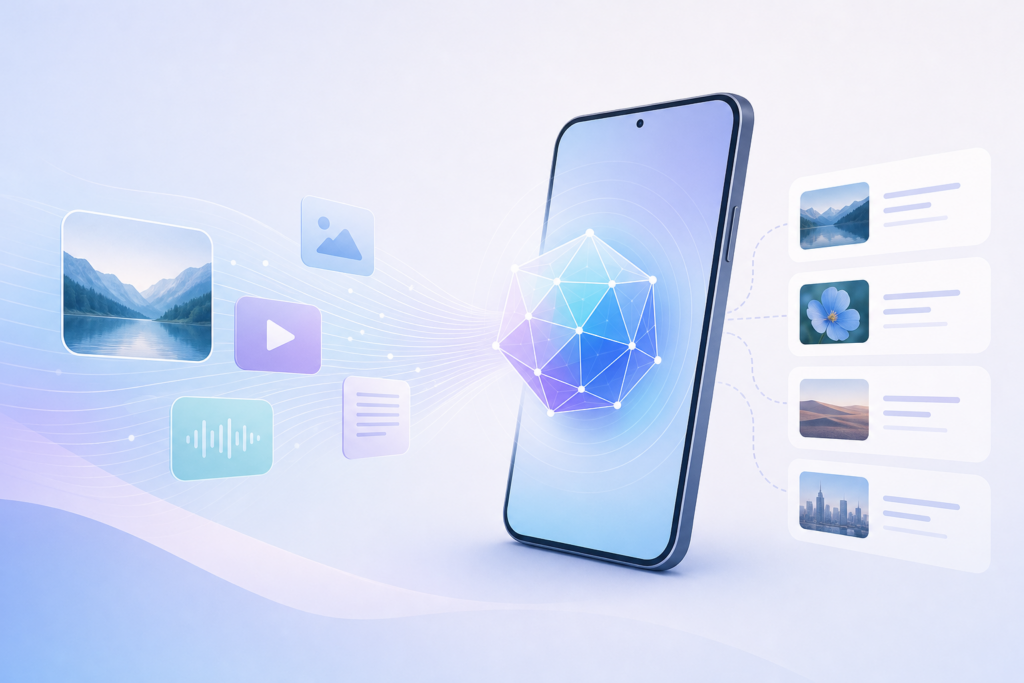
EmbeddingGemma 2は、文章だけでなく画像・音声・動画・コードまでを、共通する意味の空間に変換して検索しやすくする軽量なマルチモーダル埋め込みモデルです。クラウドへデータを送らず、スマートフォンやPCなどの端末上で動かす用途を意識して設計されている点が大きな特徴です。
この記事では、EmbeddingGemma 2の仕組み、オンデバイス検索が役立つ場面、開発者が確認したいライセンスと注意点を、初めて聞く人にも分かるように解説します。なお、以下の内容はGoogle DeepMindの発表情報と、提示された元記事の内容をもとに整理したものです。
EmbeddingGemma 2が解決する検索の課題
EmbeddingGemma 2は、異なる形式のデータを「意味の近さ」で探せるようにするモデルです。文字列が完全に一致しなくても、内容が似ている画像や動画、音声、文書を見つけやすくします。
通常のキーワード検索では、検索語とデータの中に同じ言葉が含まれていることが重要です。たとえば「犬 公園」と入力した場合、説明文やファイル名にその言葉がなければ、犬が公園を走っている動画を見つけにくい可能性があります。
埋め込み(Embedding)とは、文章や画像などの意味を、コンピューターが扱える数値の並びに変換する技術です。人間にとって意味が近いデータは、数値の上でも近い位置に置かれるように学習されます。
たとえば「犬が公園を走っている」という文章と、犬が公園を走る動画を同じ意味の地図に配置できれば、文章から動画を探す処理が可能になります。検索対象を文字だけに限定しないため、自然な言葉で個人のメディアを探す機能につながります。
EmbeddingGemma 2のマルチモーダル検索でできること
EmbeddingGemma 2の中核は、文章、画像、音声、動画、コードを横断して関連性を判断できる点です。つまり、入力した形式と検索対象の形式が同じでなくても、意味を手がかりに候補を探せます。
元記事で示されている主な組み合わせを整理すると、次のようになります。
| 入力 | 探せる対象の例 | 想定される用途 |
|---|---|---|
| 文章 | 文章、画像、動画 | 自然文による写真・映像検索 |
| 音声 | 動画、資料 | 会議録音に関連する情報の検索 |
| 画像 | 説明文、関連画像 | 画像と説明の関連付け |
| コード | コード、技術文書 | 意味ベースの開発者向け検索 |
たとえば「先週、海辺で撮った夕方の動画」と音声で話しかければ、端末に保存された動画の中から、内容や説明が近い候補を探すアプリが考えられます。これはファイル名を覚えていなくても、記憶している場面の特徴から探せるということです。
企業では、会議の録音、関連資料、画面キャプチャ、ソースコードを横断するナレッジベースにも応用できます。ただし、元記事は発表内容を中心としており、用途ごとの精度や検索速度が検証されたと述べているわけではありません。
オンデバイス処理がプライバシーと開発を変える理由
オンデバイス処理とは、クラウド上のAIへ毎回データを送るのではなく、スマートフォンやPCなどの手元の端末でAI処理を行う方式です。EmbeddingGemma 2は、このような利用を意識した軽量モデルとして紹介されています。
写真、音声、動画には、個人の行動や会話、仕事上の機密情報が含まれることがあります。検索のたびに外部サーバーへ送信する設計を避けられれば、プライバシーを重視するアプリにとって、構成を検討する余地が広がります。
- 通信環境がない場所でも利用しやすい設計を検討できる
- 検索や分類のたびに個人データをクラウドへ送らずに済む可能性がある
- クラウド利用料やサーバー側の処理負荷を抑える選択肢になる
- 端末内の写真・音声・動画を使う機能をアプリへ組み込みやすくなる
一方で、オンデバイスなら必ず通信不要、またはすべての端末で快適に動くと断定することはできません。実際の使い勝手は、端末の計算性能、メモリ、対応する実行環境、データの品質などに左右されます。
モデルの規模とライセンスから見る導入のしやすさ
EmbeddingGemma 2は、Gemma 4アーキテクチャを基盤とし、パラメータ数は7億4,000万と元記事で説明されています。超巨大モデルと比べて小型で、学習済みモデルを使って答えを出す推論を端末上で行う用途が意識されています。
モデルのサイズが比較的小さいことは、アプリへの組み込みを考えるうえで重要です。大規模なクラウド基盤を用意する方法だけでなく、端末の性能に合わせて処理を分散する方法も検討しやすくなります。ただし、必要なメモリ容量や対応環境、実行速度については、利用する端末と実装方法ごとの確認が必要です。
また、元記事ではApache 2.0ライセンスで公開されると説明されています。これは商用利用を含む幅広い利用を検討しやすい、比較的扱いやすいオープンソース系のライセンスですが、実際に組み込む際は配布条件や表示義務など、ライセンス本文の確認が欠かせません。
- 対象端末の計算性能とメモリを確認する
- 利用する実行環境とモデル形式が合うか調べる
- 検索対象のデータを端末内でどのように整理するか決める
- プライバシー、ライセンス、更新方法を設計段階で確認する
このように、軽量モデルは導入の可能性を広げますが、モデルを置くだけで製品機能が完成するわけではありません。データの前処理、検索結果の表示、誤った候補への対応など、アプリ全体の設計も同じくらい重要です。
RAGや個人向けアプリへの応用と今後の課題
EmbeddingGemma 2は、検索拡張生成とも呼ばれるRAG(検索拡張生成)にも関係します。RAGは、AIが回答を作る前に用意された資料やデータベースを検索し、その情報を参考にして答える仕組みです。
前世代のEmbeddingGemmaについて、Googleは20 million回以上ダウンロードされ、オンデバイス検索やプライバシーを重視したRAGに利用されたと説明しています。これは前世代に関する発表情報であり、EmbeddingGemma 2の精度や利用実績を直接示す数値ではない点に注意が必要です。
個人向けには、自然な言葉で写真や動画を探せるアルバムが考えられます。企業向けには、会議音声、設計資料、画面キャプチャ、ソースコードを意味で結び付ける社内検索が候補になります。開発者向けには、端末の外へデータを送らずに動かすAI検索機能が検討対象になるでしょう。
AI検索は、キーワードを入力するだけでなく、「この話をしている場面」「こういう雰囲気の写真」と伝えて探す方向へ広がる可能性があります。
ただし、今回の発表情報だけでは、用途ごとの詳細な精度、速度、他モデルとの比較結果までは判断できません。データの種類によっては意味の読み取りが難しく、音声の品質や画像の内容、動画の切り出し方が検索結果に影響することも考えられます。
それでも、EmbeddingGemma 2が示す方向性は明確です。巨大なモデルをクラウドで利用するだけでなく、小型のモデルを端末へ置き、個人データをその場で理解するAIアプリが増えれば、検索とプライバシーの両立を考える機会がさらに広がります。導入を検討する際は、発表内容だけで結論を出さず、対象端末と実データに合わせた評価を行うことが大切です。
出典: EmbeddingGemma 2: an open, lightweight multimodal embedding model
よくある質問
EmbeddingGemma 2とはどのようなAIモデルですか?
EmbeddingGemma 2は、文章だけでなく画像、音声、動画、コードも数値の並びに変換し、異なる形式のデータを意味の近さで検索しやすくする軽量なマルチモーダル埋め込みモデルです。
EmbeddingGemma 2はスマートフォンで利用できますか?
端末上での推論を意識して設計されたモデルですが、実際に利用できるかや快適に動くかは、スマートフォンの計算性能、メモリ、対応する実行環境、アプリ側の実装によって変わります。
EmbeddingGemma 2でどのような検索が可能になりますか?
文章から画像や動画を探したり、音声に関連する映像や資料を検索したり、画像と説明文を関連付けたりできます。キーワードが完全一致しなくても、データの意味の近さを手がかりに検索する用途が想定されています。