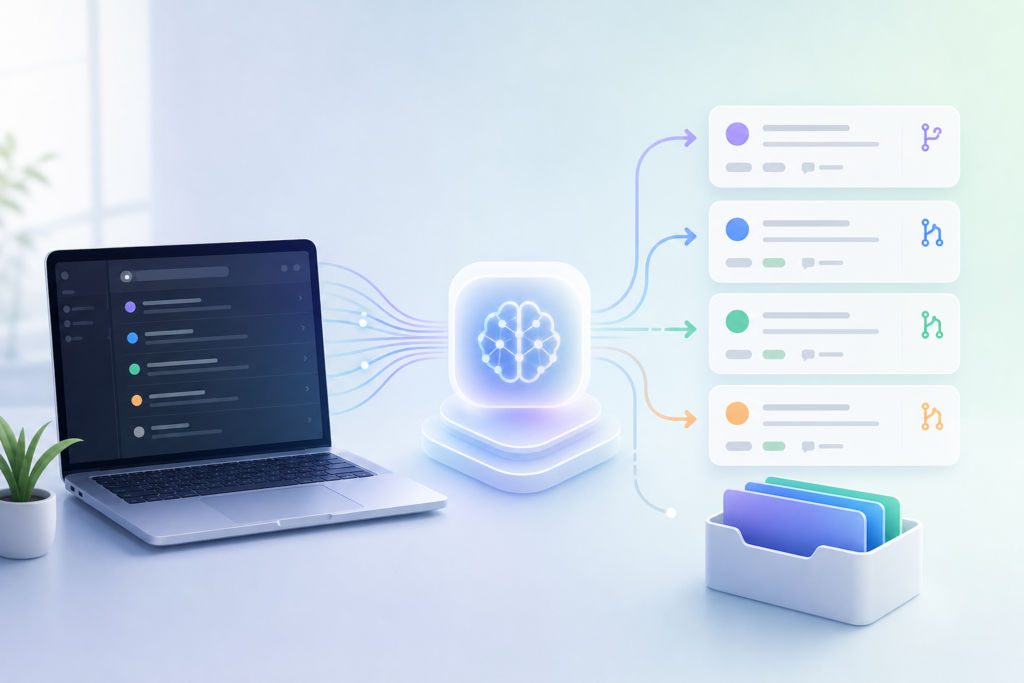
ローカルAIを使えば、GitHubに届く大量のIssueやPRを、クラウドAIの継続課金に頼らず整理する仕組みを作れます。OpenClawの事例では、IssueやPRの分類、ラベル付け、優先順位付け、対応先の整理をAIに任せ、人間は重要な判断に集中する設計が紹介されています。
ただし、ローカルAIは人間の代わりに最終決定を下すものではありません。分類結果を確認しながら、プロンプト、ラベルのルール、利用モデルを調整していくことが、安定した運用への近道です。
ローカルAIがGitHubのIssue・PR整理に向いている理由
ローカルAIがGitHubの整理に向いている理由は、定型的な分類作業を自分のPCやサーバー内で繰り返し実行できるからです。IssueやPRを毎回読み、人間が同じ項目を確認する負担を減らせます。
オープンソースプロジェクトでは、バグ報告、新機能の要望、質問、重複報告、コード変更の提案などが混在します。件数が増えるほど、メンテナーはコードを書く前に、内容の確認やラベル付けへ多くの時間を使うことになります。
ここでローカルAIを受付担当者のように配置すると、受け取った内容を一定のルールで振り分けられます。たとえば、バグか機能要望か、どの分野に関係するか、優先度は高いか、追加確認が必要かといった項目を先に整理できます。
クラウドAIとの違いを整理する
| 観点 | ローカルAI | クラウドAI |
|---|---|---|
| 処理場所 | 自分のPCやサーバー | 提供事業者のクラウド |
| 費用 | 環境を用意した後は追加課金が発生しにくい | 利用量に応じた料金が発生する場合がある |
| データ管理 | 外部へ送信せず処理しやすい | サービスの仕組みに依存する |
| 性能 | モデルや機器の性能に左右される | 高性能なモデルを使える場合がある |
元記事で紹介されている「FREE」という表現は、完全に費用がゼロという意味ではありません。電気代や機器の準備が必要で、ローカルモデルを動かせる環境が前提になります。それでも、同じ処理を繰り返すたびにAPI利用料が増える方式とは、費用の考え方が異なります。
OpenClawの事例で分かる自動トリアージの流れ
OpenClawの事例では、GitHubに届いたIssueやPRを読み込み、あらかじめ定めたラベルや分類項目へ振り分けます。つまり、ローカルAIは最終回答を作るよりも、最初の受付と仕分けを担当しています。
記事では、GemmaやQwenのようなローカルで動かせるモデルと、AIエージェント用の仕組みであるPiを組み合わせています。AIエージェントとは、入力を受け取り、決められた手順に沿って処理し、外部ツールとの連携まで行う仕組みです。
処理の流れを単純化すると、次のようになります。重要なのは、AIに自由な感想を書かせるのではなく、後続処理で扱いやすい形式を最初から指定することです。
- 新しいIssueやPRの本文、タイトル、関連情報を読み込む。
- 分類、対象分野、優先度、追加確認の要否を判断させる。
- 決められた形式で結果を受け取り、GitHubのラベルや一覧に反映する。
- 人間が結果を確認し、誤分類や見落としを記録する。
自動化できる代表的な作業
- 新しいIssueをバグ、機能要望、質問などに分類する。
- 既存のラベルを確認し、付け忘れや不整合を見つける。
- 緊急度や影響範囲を整理し、確認すべきIssueを絞り込む。
- PRの変更内容を読み、レビュー対象として整理する。
- 重複している可能性や、追加情報が必要な報告を見つける。
この方式は、メールの受信箱を自動整理する仕組みに似ています。AIが「重要」「確認が必要」「後回し」と仕分けすれば、人間はすべてを同じ熱量で読む必要がなくなります。作業を完全に消すというより、読む順番と確認範囲を整えることが目的です。
構造化出力でAIの分類結果を業務につなげる
構造化出力を使うと、AIの返答をプログラムで読み取りやすい決まった形にできます。GitHubのラベル付けや通知へつなげるには、自然文だけの回答よりも、項目と値がそろった結果のほうが扱いやすくなります。
通常のチャットでは、「これはバグのようです。優先度は高そうです」といった文章が返ることがあります。人間には理解できても、プログラムが毎回同じ方法で読み取るのは簡単ではありません。
そこで、次のように項目を固定します。これは、受付担当者に記入欄の決まったフォームを渡すイメージです。
| 項目 | 入力例 | 利用目的 |
|---|---|---|
| 分類 | bug | バグ用ラベルを付ける |
| 優先度 | high | 確認する順番を整理する |
| 対象 | authentication | 担当分野を推定する |
| 追加確認 | 必要 | 投稿者への質問候補を示す |
ルール設計で先に決めること
構造化出力を導入する前に、分類項目の意味を決めておく必要があります。たとえば「high」が何を指すのか、再現手順がない報告をどの分類にするのか、判断できない場合にどの値を返すのかを明文化します。
選択肢を増やしすぎると、AIだけでなく人間も迷いやすくなります。最初は少数のラベルから始め、運用中に発生した例外を見ながらルールを追加するほうが、現場で扱いやすい仕組みになります。
また、AIの出力をそのまま公開返信に使うのではなく、まずは下書き、内部ラベル、確認待ち一覧として利用する方法が安全です。自動化の範囲を小さく始めれば、誤った分類がプロジェクト全体へ広がるリスクを抑えられます。
ローカルAI運用で注意すべき限界と確認方法
ローカルAIにも誤解、誤分類、見落としが起こるため、最終判断を丸投げしてはいけません。現実のリポジトリで動かし、分類結果を確認しながらプロンプトやルールを調整することが必要です。
Issueの文章には、短い説明、専門用語、複数の問題、再現条件の不足などが含まれます。単純なキーワードだけでは判断できない場合もあり、似た報告を重複と誤認したり、重要な問題の優先度を低くしたりする可能性があります。
そのため、運用では「AIが何件処理したか」だけでなく、「人間が修正した分類は何か」「確認が必要とされた報告は妥当だったか」を記録します。元記事でも、実際の運用中にモデルがどの程度正確に動くかを追跡し、検証する重要性が示されています。
安全に導入する段階
- 観察段階:AIに分類させるだけで、GitHubの状態は自動変更しない。
- 補助段階:AIの結果を人間が確認してからラベルや一覧へ反映する。
- 限定自動化:確信度や条件が明確な処理だけを自動実行する。
- 継続改善:誤分類の例を使い、ルールやモデルを見直す。
「確信度」という言葉を使う場合も、数値を過信しないことが大切です。AIが自信ありげに答えても、それが正しさを保証するわけではありません。重要なセキュリティ報告や利用者への返信などは、人間が内容を確認する工程を残しておくべきです。
クラウドとローカルAIを使い分ける設計
すべてをローカルAIに任せるか、すべてをクラウドAIに任せるかの二択にする必要はありません。単純な分類はローカルAI、難しい判断は高性能なモデルや人間という分担が、現実的な設計になります。
ローカルモデルは、Issueやコードを外部サービスへ送らずに処理しやすい点が利点です。また、モデルの提供停止、料金変更、利用規約の変更、サービス障害といった外部サービス依存のリスクを減らせます。
一方で、複雑な推論や微妙なニュアンスの理解では、より大きなクラウドモデルのほうが適している場面もあります。モデルの性能は入力内容や実行環境にも左右されるため、用途ごとに役割を分けることが重要です。
| 処理内容 | 向いている担当 | 理由 |
|---|---|---|
| 定型的なラベル分類 | ローカルAI | 繰り返し処理しやすく、外部送信を抑えやすい |
| 機密性の高い内容の一次整理 | ローカルAI | 自社環境内で処理する設計にしやすい |
| 複雑な原因分析 | 高性能モデルや人間 | 文脈や細かな条件の確認が必要になる |
| 公開返信や重要な判断 | 人間 | 誤解が利用者やプロジェクトへ直接影響する |
まずはIssueの分類や確認待ち一覧の作成など、小さな作業から始めるとよいでしょう。ローカルAIの価値は、一番賢いモデルを選ぶことだけで決まるものではありません。自分の仕事のどこを、どのモデルに、どの範囲まで任せるかを設計することが、継続的な自動化につながります。
出典: We got local models to triage the OpenClaw repo for FREE!*
よくある質問
ローカルAIとは何ですか?
ローカルAIとは、クラウド上のAIサービスへ文章やコードを送るのではなく、自分が所有するPCやサーバー上でAIモデルを実行する仕組みです。データ管理や費用、利用環境を自分でコントロールしやすい点が特徴です。
ローカルAIだけでGitHubのIssue対応を完結できますか?
分類やラベル付けなどの定型作業はローカルAIに任せられますが、重要なIssueの最終判断や公開返信まで完全に自動化するのは慎重さが必要です。誤分類や見落としを確認するため、人間のレビュー工程を残す設計が現実的です。
構造化出力を使うと何が便利になりますか?
構造化出力を使うと、分類、優先度、対象分野、追加確認の要否などを決められた形式で受け取れます。そのため、AIの回答をGitHubのラベル付け、通知、担当者の整理など後続のプログラム処理へつなげやすくなります。
ローカルAIの導入で費用は完全にゼロになりますか?
完全にゼロになるとは限りません。モデルを動かすPCやサーバーの準備費用、電気代、管理の手間が必要です。ただし、クラウドAIのように処理量に応じた追加料金が発生する方式とは異なり、一定量の処理を繰り返しやすい利点があります。